Loading...
Gemini 4 Argon: Guía Práctica para Construir un Agente DevSecOps Autónomo
Publicado: 10/1/2026
Gemini 4 Argon: Guía Práctica para Construir un Agente DevSecOps Autónomo
Aquí el Equipo PAI. Sabemos que tienes que implementar esto rápido. Menos teoría, más acción. Gemini 4 Argon no es solo otro LLM conversacional; es el nuevo modelo de frontera de Google diseñado específicamente para flujos de trabajo complejos y a largo plazo.
Los datos hablan por sí solos: Argon iguala a GPT-6 Astra con una puntuación de 53 en el Artificial Analysis Intelligence Index. Con un límite amplio de tokens de salida y un enfoque nativo en ciberdefensa y detección autónoma de vulnerabilidades, está hecho para procesar repositorios enteros y proponer refactorizaciones completas.
Vamos a ensuciarnos las manos.
1. El Objetivo del Tutorial
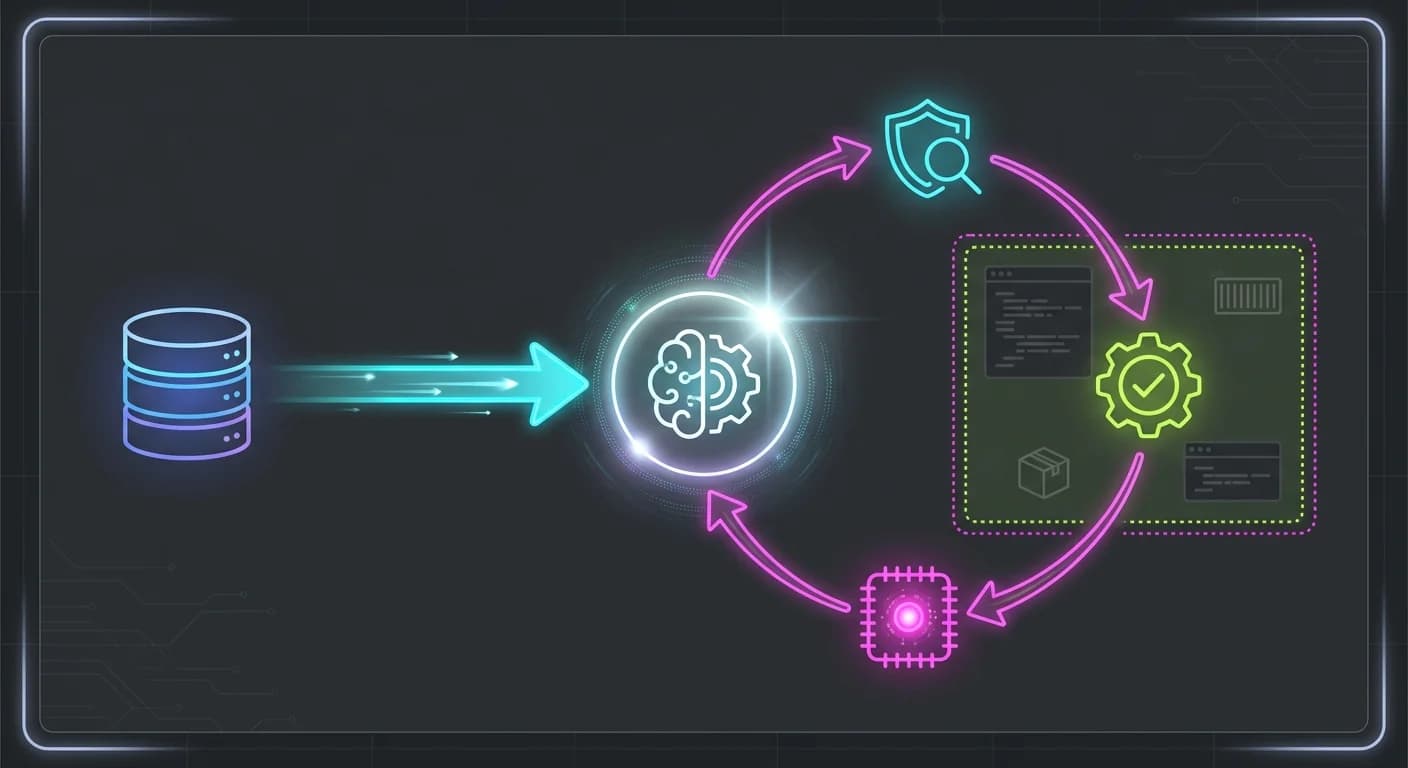
¿Qué vamos a construir hoy? Un Agente DevSecOps Autónomo. Le pasaremos un repositorio de código como contexto estable, le daremos acceso a un entorno de pruebas, y le pediremos que encuentre vulnerabilidades, las valide y proponga los parches. Todo en una sola trayectoria de razonamiento profundo.
2. Prerrequisitos para el Proyecto
- Acceso al Modelo: Actualmente, Argon se está desplegando primero para expertos en ciberseguridad a través del programa Fairwind. Necesitarás estar en este grupo o esperar la disponibilidad general.
- Python 3.10+: Necesario para un manejo robusto de asincronía y streaming.
- SDK de Google AI: Instala la librería oficial ejecutando:
bash
- API Key: Configurada en tu gestor de secretos como Vault o Secret Manager. ¡Nunca en texto plano!
3. Guía Paso a Paso
Paso 1: Configurar el Cliente y la Estrategia de Caché
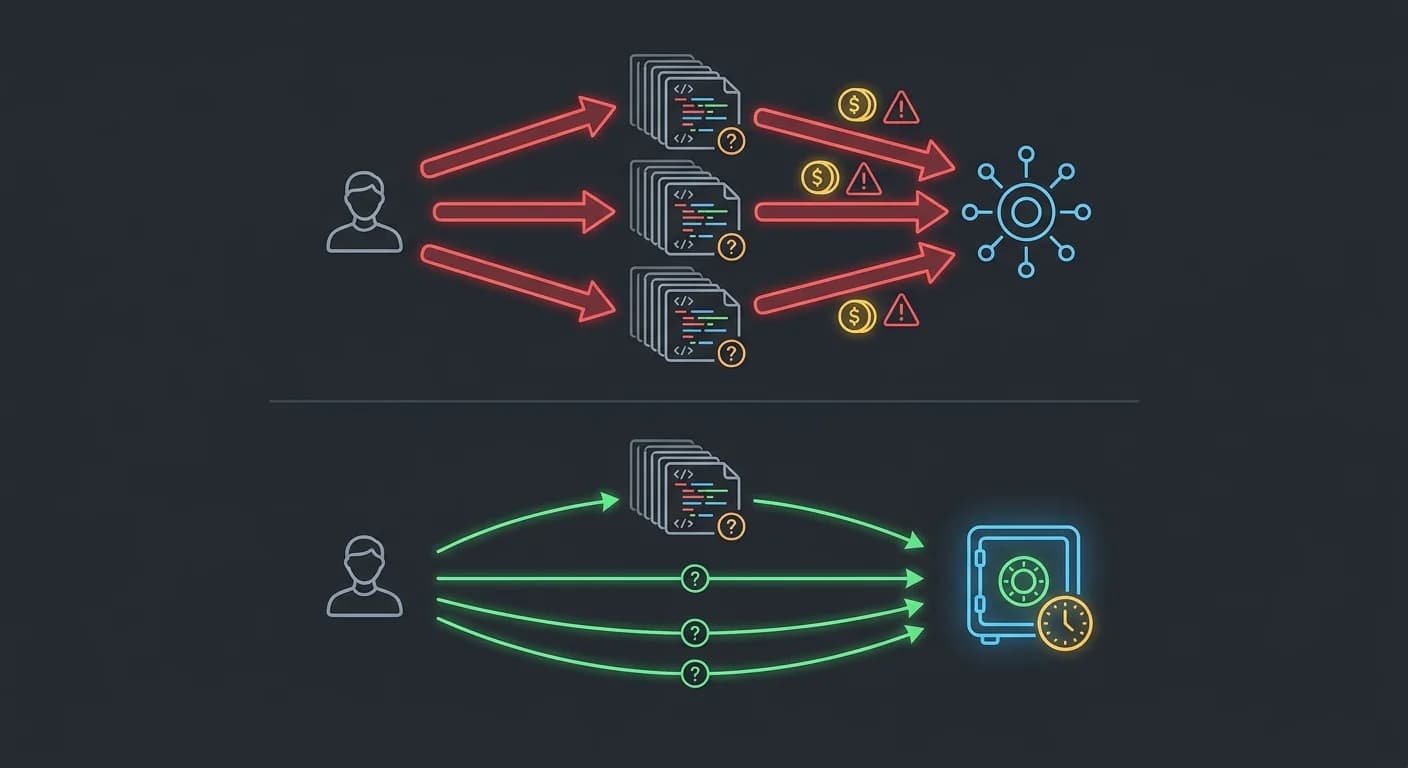
Argon es potente, pero procesar millones de tokens es costoso. El secreto es usar el caché de contexto. Si vas a analizar una base de código, cárgala una sola vez.
python
Paso 2: Definir las Herramientas y Restricciones
Argon es un modelo orientado a agentes. Necesita herramientas para actuar. Pero cuidado, en ciberseguridad, Argon está alineado solo para defensa. Si le pides que explote algo para atacar, sus filtros bloquearán la petición.
python
Paso 3: Crear el Bucle del Agente
Aquí ocurre la magia. Usaremos una temperatura baja de 0.2 porque queremos análisis determinista, no creatividad literaria. Además, limitaremos los tokens de salida para mantener el control de los costos.
python
Consejo Experto: Contexto Estable vs. Dinámico
El secreto mejor guardado para escalar agentes con Argon es la separación de contextos. Nunca envíes el código fuente y el prompt del usuario en el mismo payload si vas a hacer múltiples llamadas. Carga el código fuente como Contexto Estable en la API de Caché. Luego, en cada iteración del agente, envía solo las instrucciones nuevas como Contexto Dinámico. Esto reduce la latencia drásticamente y optimiza los costos en las iteraciones.
4. Errores Comunes y Cómo Evitarlos
Seguro te encontrarás con estos obstáculos en tu primera semana:
- El agujero negro de los tokens de salida: Argon está diseñado para tareas de larga duración. Si dejas el parámetro
max_output_tokensabierto y el modelo entra en un bucle de refactorización, te costará caro. Fija siempre un límite (por ejemplo, 10k - 20k) según la tarea. - Filtros de Seguridad y Alineación: Argon es resistente a la inyección de prompts y tiene guardarraíles estrictos. Si tu prompt dice "Simula un ataque de inyección SQL", te bloqueará. Cambia el enfoque a: "Audita este código buscando vulnerabilidades de inyección SQL y propón defensas".
- Prompts vagos en flujos largos: Argon no es adivino. Si le dices "Mejora este código", se perderá en refactorizaciones de estilo. Usa prompts estructurados: "1. Analiza complejidad ciclomática. 2. Desacopla la base de datos. 3. Genera tests unitarios".
5. Siguientes Pasos para Producción
¿Quieres llevar esto a producción? Sigue estas recomendaciones:
- Human-in-the-Loop (HITL): Argon es increíble detectando fallos, pero no lo dejes hacer
git pusha la ramamaindirectamente. Configura el agente para que abra Pull Requests que requieran aprobación humana. - Métricas de Costo-Beneficio: Implementa telemetría en tu wrapper de la API. Mide el costo por tarea, como el costo por bug resuelto. Argon es un modelo de frontera; úsalo para tareas complejas, y delega el pre-procesamiento a modelos más baratos.
- Monitoreo de Cadena de Pensamiento: Aprovecha los logs del agente para auditar por qué tomó ciertas decisiones. Es vital para el cumplimiento normativo en sectores financieros y legales.
¡A codear! El futuro de los agentes autónomos ya está en tus manos.
Gemini 4 Argon
DevSecOps
LLM
Google AI
Tutorial